Datos
PostgreSQL 18 y búsqueda híbrida: texto y vectores en una sola base
Cuándo combinar búsqueda léxica, pgvector y reordenamiento sin construir una plataforma de datos innecesaria.
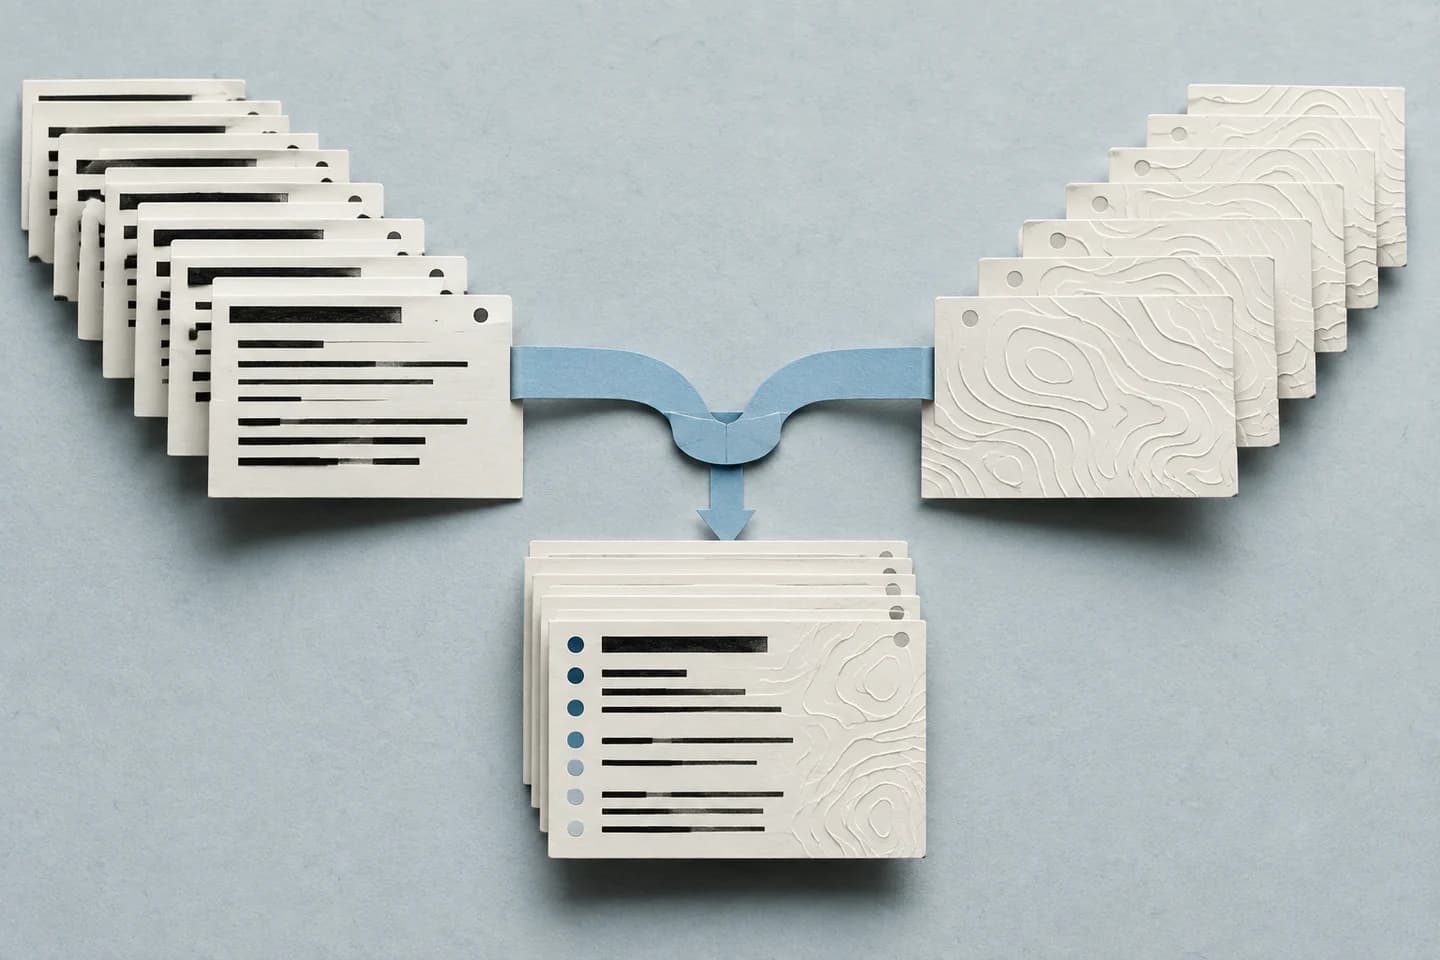
La idea central
Recupera por texto y por significado, aplica permisos en ambos caminos y compara la relevancia antes de añadir complejidad al ranking.
La búsqueda semántica encuentra cercanía conceptual, pero puede perder términos exactos, códigos o nombres. La búsqueda de texto hace lo contrario. Un enfoque híbrido recupera candidatos de ambos caminos y fusiona sus posiciones antes de un posible reordenamiento.
pgvector ofrece búsqueda exacta e índices aproximados HNSW e IVFFlat. HNSW suele dar mejor relación entre velocidad y recall a cambio de memoria y tiempo de construcción. Sus parámetros deben medirse con el conjunto real, especialmente cuando existen filtros por tenant o categoría.
Pipeline de recuperación híbrida
01
Texto
Términos y códigos dentro del contenido autorizado
02
Vectores
Similitud conceptual dentro del contenido autorizado
03
Fusión RRF
Combina posiciones
04
Ranking final
Resultados ordenados por relevancia
PostgreSQL 18 mejora E/S, índices, observabilidad y mantenimiento, lo que fortalece la base operativa alrededor de estas consultas. Aun así, la calidad depende de embeddings, partición, estrategia de actualización y métricas de relevancia, no solo del tipo vector.
Para muchos productos, mantener texto, permisos, metadatos y vectores en PostgreSQL reduce sincronización y superficie operativa. Separar un motor especializado tiene sentido cuando la escala o las capacidades de ranking lo justifican con datos.
Separar recuperación y ranking
La primera etapa busca cobertura rápida y devuelve candidatos. La segunda combina señales y ordena. Esta separación permite medir si el problema está en embeddings, consulta léxica, filtros o reranking. También evita pedir a un modelo costoso que revise documentos que nunca debieron llegar al conjunto candidato.
Elegir índices con filtros reales
HNSW e IVFFlat se comportan distinto bajo memoria, actualizaciones y filtros por tenant. El benchmark debe usar distribución, idioma y permisos reales. Un índice muy rápido que pierde documentos relevantes después de aplicar filtros no cumple el objetivo, aunque su latencia aislada parezca excelente.
Fusionar sin calibrar puntuaciones incompatibles
Reciprocal Rank Fusion combina posiciones y evita asumir que la puntuación textual y la distancia vectorial viven en la misma escala. Los pesos pueden ajustarse por tipo de consulta. Los códigos exactos favorecen texto; preguntas conceptuales suelen beneficiarse más de la señal semántica.
Medir calidad, latencia y operación
Hace falta un conjunto de consultas con juicios de relevancia y métricas como recall, MRR o nDCG, además de p95 y costo. También se supervisan crecimiento del índice, vacuums, actualizaciones de embeddings y consistencia de permisos. La búsqueda es una capacidad de producto, no una consulta aislada.
Caso didáctico
Encontrar una política por su código o por su significado
Piensa en un buscador de soporte. “ERR-1042” necesita una coincidencia precisa; “no puedo entrar después de cambiar de teléfono” necesita proximidad conceptual. Un único recuperador puede resolver muy bien un caso y perder el otro. Prepara consultas representativas de ambos tipos, incluyendo preguntas sin respuesta y documentos restringidos.
La fusión RRF suma aportaciones según la posición de cada documento: 1 / (k + posición) por lista en la que aparece. En un ejemplo con k = 60, un documento en posiciones 1 y 8 obtiene aproximadamente 0.03110; otro en 3 y 2 obtiene 0.03200. El segundo queda por encima al tener mejor presencia conjunta. k = 60 es una elección para ilustrar el cálculo, no una garantía de calidad.
Deduplica por documento y conserva el origen de cada candidato para investigar resultados. Los filtros de acceso deben aplicarse en ambos recuperadores antes de entregar contenido al reranker o al modelo. Con índices aproximados, filtros selectivos pueden reducir los candidatos disponibles: compara contra búsqueda exacta y mide recall, latencia y cobertura por grupo antes de aumentar parámetros.
Qué elegir y qué implica
| Situación | Decisión | Límite a considerar |
|---|---|---|
| Códigos y nombres exactos | Asegurar recuperación léxica y normalización adecuada. | El análisis lingüístico puede requerir un tratamiento especial para identificadores. |
| Paráfrasis y vocabulario distinto | Añadir candidatos semánticos. | La similitud no demuestra que el documento responda la pregunta. |
| Mezclar listas con scores diferentes | Evaluar fusión por posiciones. | RRF pierde la magnitud original de los scores; valida con consultas reales. |
Desliza la tabla para comparar las tres columnas.
Llévalo a la práctica
Evalúa antes de cambiar de motor
- Crea un conjunto revisado de consultas, documentos esperados y permisos.
- Compara texto, vectores e híbrido con el mismo límite de resultados.
- Inspecciona fallos de relevancia, ausencia de respuesta y filtros selectivos.
Qué comprobar: La mejora aparece en consultas representativas, mantiene el aislamiento de acceso y cabe dentro del presupuesto de latencia.
Una base antes que una plataforma
PostgreSQL puede resolver búsqueda híbrida con menos sincronización y permisos coherentes. La decisión de separar un motor debe llegar después de medir límites reales, no antes de comprobar que la complejidad adicional compra una mejora relevante.
Para seguir leyendo
IA y agentes
Agentes con MCP: útiles por diseño, seguros por control
Cómo exponer herramientas a un agente sin convertir cada integración en un permiso implícito.
Cloud y plataforma
La plataforma interna ahora sirve a equipos y agentes
Golden paths, autoservicio y políticas para una organización donde humanos y agentes consumen la misma plataforma.