Cloud y plataforma
Kubernetes y recursos especializados: más allá de CPU y memoria
Qué aporta Dynamic Resource Allocation para GPUs, aceleradores y dispositivos en plataformas cloud-native.
La idea central
DRA permite describir necesidades de dispositivos con más precisión. La disponibilidad sigue dependiendo del inventario, el driver y las capacidades de la versión desplegada.
Las cargas de IA y procesamiento especializado necesitan seleccionar, compartir y configurar dispositivos que no encajan bien en el modelo tradicional de recursos extendidos. Dynamic Resource Allocation introduce una API más expresiva para describir esa relación.
En Kubernetes 1.34 el núcleo de DRA llegó a estable. Esto permite separar la solicitud del recurso, las capacidades del dispositivo y la lógica del driver, con mejor soporte para GPUs, TPUs, NICs y otros aceleradores.
Asignación dinámica de un dispositivo
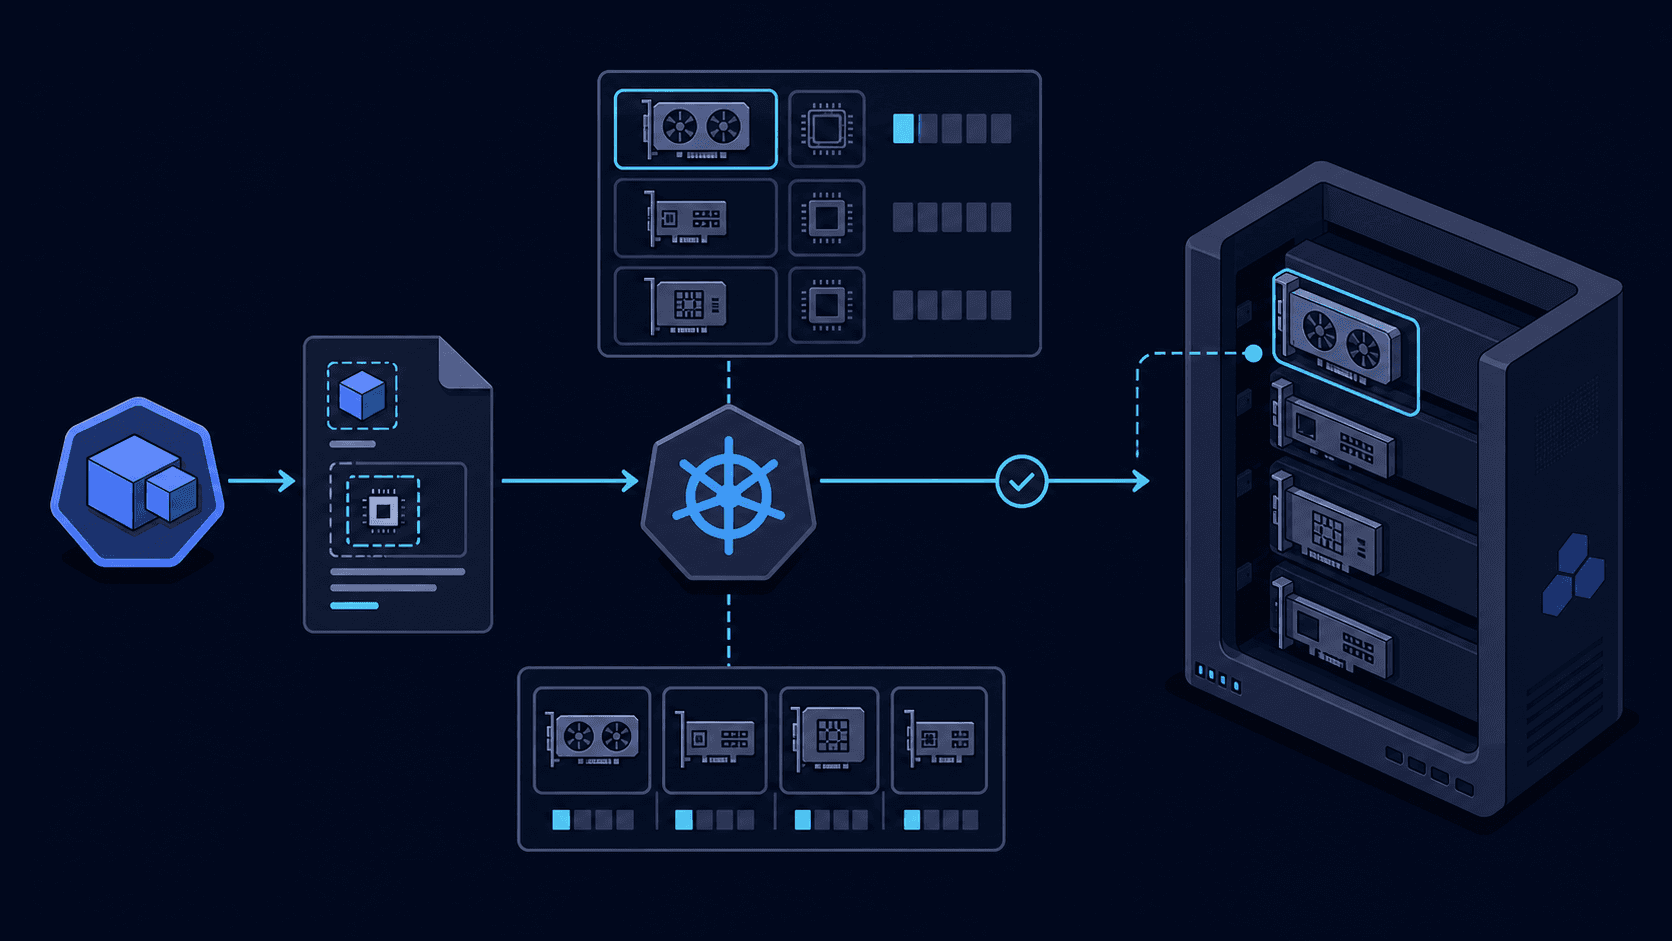
La mejora no elimina la planeación de capacidad. Los equipos necesitan clases de recursos, cuotas, observabilidad, aislamiento y políticas de prioridad que reflejen el costo y la criticidad de cada carga.
Para una plataforma interna, DRA puede convertirse en una capacidad de autoservicio: el desarrollador solicita un perfil aprobado y la plataforma resuelve proveedor, nodo y configuración. El detalle de infraestructura deja de filtrarse a cada aplicación.
Superar el contador de recursos extendidos
CPU y memoria son fungibles; los dispositivos tienen modelos, capacidades, topología y modos de compartir. DRA separa la intención de la carga de los detalles del inventario. Esto permite expresar requisitos más ricos sin codificar nombres de nodos o proveedores dentro de cada manifiesto.
Entender Claim, Class y driver
El ResourceClaim representa la solicitud y puede vivir junto al Pod o reutilizarse según el caso. Las clases ofrecen perfiles aprobados. El driver publica dispositivos y prepara su acceso. La separación ayuda a que plataforma defina opciones y el equipo de aplicación elija una capacidad estable.
Planear capacidad y scheduling
DRA mejora la expresión, pero no crea GPUs. Quotas, prioridad, topology awareness y observabilidad siguen siendo esenciales. Las métricas deben mostrar inventario, asignaciones pendientes, utilización, fallos del driver y costo. Una solicitud imposible necesita un error que permita corregir clase, región o tamaño.
Ofrecer perfiles como producto de plataforma
Un equipo puede pedir “inferencia estándar” o “entrenamiento intensivo” mientras la plataforma mapea esa intención a proveedor y dispositivo. Los perfiles incorporan límites, seguridad y costo. El contrato desacopla aplicaciones de cambios de hardware y facilita mover cargas entre clusters con capacidades equivalentes.
Caso didáctico
Un trabajo de inferencia pendiente pese a tener GPUs libres
Un clúster dispone de varias GPUs, pero el trabajo pide una capacidad que solo algunas ofrecen. Contar dispositivos libres no basta: importan atributos, compatibilidad del driver, topología y restricciones de asignación. El diagnóstico debe empezar por la solicitud y el inventario que realmente ve Kubernetes.
El equipo de plataforma puede publicar perfiles mediante DeviceClass y permitir que los trabajos soliciten recursos a través de ResourceClaim. Un driver publica inventario mediante ResourceSlice y prepara los dispositivos asignados. Esto separa la necesidad de la aplicación de los detalles del hardware, sin prometer que cualquier clúster pueda satisfacer el mismo perfil.
El núcleo de DRA se estabilizó en Kubernetes 1.34, pero las capacidades adicionales tienen su propio ciclo de madurez. No asumas que compartir, particionar o administrar dispositivos funciona igual en todas las versiones y drivers. Antes de publicar un perfil, documenta compatibilidad, aislamiento, límites y comportamiento al retirar o reiniciar un nodo.
Qué elegir y qué implica
| Situación | Decisión | Límite a considerar |
|---|---|---|
| Solicitud pendiente | Comparar requisitos con inventario y eventos de asignación. | Capacidad libre no equivale a capacidad compatible. |
| Perfil compartido entre equipos | Definir DeviceClass y condiciones de uso. | La disponibilidad y el aislamiento dependen del driver. |
| Migración entre clústeres | Validar versión, API y driver del destino. | El mismo nombre de perfil no demuestra equivalencia de hardware. |
Desliza la tabla para comparar las tres columnas.
Llévalo a la práctica
Valida el ciclo de vida del recurso
- Prueba una solicitud compatible y otra imposible de satisfacer.
- Observa asignación, preparación y consumo desde el workload.
- Finaliza el trabajo y verifica la política de retención o eliminación de su claim antes de esperar la liberación.
Qué comprobar: Puedes explicar por qué una solicitud espera y demostrar cómo se recupera la capacidad cuando se libera el claim.
Abstraer sin ocultar la capacidad
DRA permite una interfaz más limpia para recursos especializados. La abstracción funciona cuando plataforma hace visibles disponibilidad, costo y límites; esconderlos por completo solo traslada la sorpresa al scheduler.
Para seguir leyendo
Cloud y plataforma
La plataforma interna ahora sirve a equipos y agentes
Golden paths, autoservicio y políticas para una organización donde humanos y agentes consumen la misma plataforma.
Cloud y plataforma
FinOps en Azure: pasar del costo mensual al valor del producto
Un ciclo operativo para asignar gasto, detectar desperdicio y tomar decisiones técnicas con contexto de negocio.